 Technical Note - Transformer
Transformer とは
発表:Vaswani et al., “Attention Is All You Need,” 2017
入力系列データから出力系列データを推論する seq2seq の問題を解く Encoder-Decoder モデルの1つ。
それまでの RNN や LSTM による seq2seq では、
- ある時刻(位置)$t$ の隠れ状態 $\boldsymbol{h}_t,\boldsymbol{c}_t$ を計算
- それを使って次の時刻 $t+1$ の隠れ状態 $\boldsymbol{h}{t+1}, \boldsymbol{c}{t+1}$を計算
- 1,2を系列の長さの分だけ繰り返す
といった処理が必要になり、この部分は直列にしか計算ができないため計算コストが大きい。
そこで、それまでの seq2seq でも RNN と組み合わせる形で利用されていた Attention の技術に着目し、RNN を使わず Attention のみを用いて系列情報を取り扱う Transformer の手法が開発された。
概観
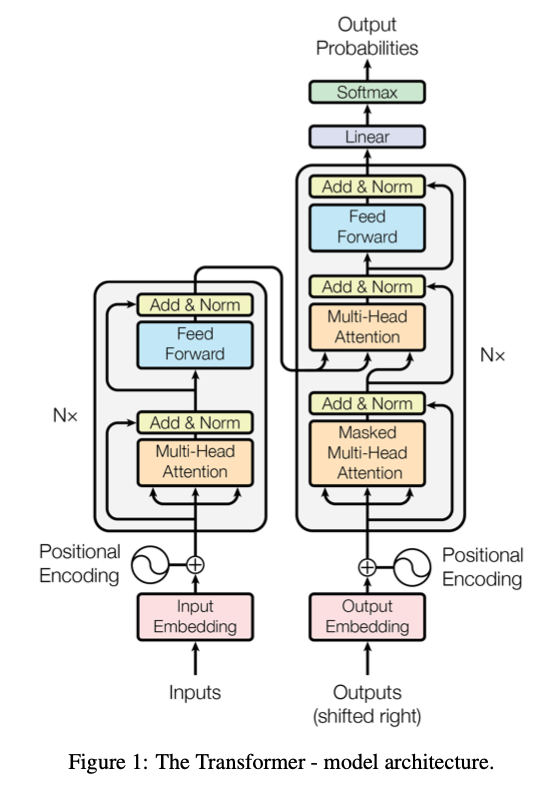 (Vaswani et al., “Attention Is All You Need,” 2017)
| 処理層 | 説明 |
|---|---|
| Input Embedding / Output Embedding | 単語を分散表現(ベクトル)に embedding |
| Positional Encoding | 系列中のどの時刻に出現したか、に応じて異なる値を加算することで、ベクトルに時刻(出現位置)の情報を付加 |
| Self-Attention | Encoder 側(図の左側)の “Multi-Head Attention”。 入力系列内の各要素に対して、他の全ての要素との関連性を計算し、各要素のベクトル表現を更新 = 単語(要素)単体ではなく、系列全体から俯瞰して見たときの単語のベクトル表現を計算 |
| Masked Self-Attention | Decoder 側(図の右側)の “Masked Multi-Head Attention”。 未来(そこより先の位置)の情報をマスクして参照しないようにした Self-Attention |
| Cross-Attention | Decoder 側(図の右側)の “Multi-Head Attention”。 Encoder 側で計算した系列全ての要素と、Decoder 側の要素との関連性を計算し、Decoder 側の要素のベクトル表現を更新 |
| Feed Forward | 全結合層・活性化層で構成されるシンプルな MLP |
| Add & Norm | ・Add = Residual Connection, 残差接続(MLP を参照) ・Norm = Layer Normalization(RNN を参照) |
各層の処理
Self-Attention, Cross-Attention
Transformer の中核技術。順に解説する。
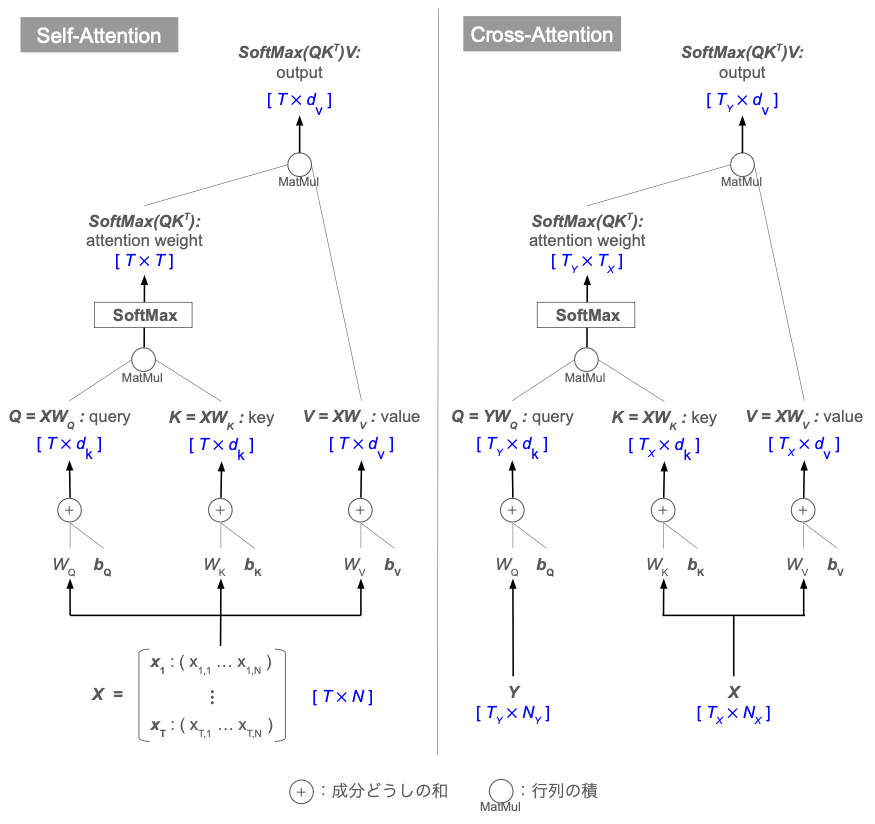
Key と Value
情報を取り出す対象のデータから生成するデータベース(Key-Value store)のようなイメージ。
- Key:情報を引くための索引
- Value:Key を元に引き当てて、実際に取り出す情報
それぞれ、時刻(位置)ごとに作成する。
Key はあくまで検索インデックスのようなものであり、実際に取り出す情報 Value とは分けて扱う。
そのため、Key, Value のデータの形式(特徴量次元)は異なっていて良い。
一般にはいずれもベクトルの形式で表現されるので、以後、Key, Value それぞれの特徴量次元を $d_K, d_V$ で表す。
具体的な計算は、単純に重み行列 $W_K, W_V$ を元データにかければ良く、元データの時系列長を $T_X$ とすれば、各時刻のデータからそれぞれ Key, Value のベクトルが作られるので、Key $K$ は $T_X \times d_K$ 行列、Value $V$ は $T_X \times d_V$ 行列となる。
\[K = X W_K,\quad V = X W_V\]ここで $X$ は Key, Value を計算するための元データであり、元データの特徴量次元を $N_X$ とすれば、重み $W_K,W_V$ はそれぞれ $N_X \times d_K,\ N_X \times d_V$ 行列。
Query
Query = Key, Value からなるデータベースから欲しい情報を引くための検索クエリのようなイメージ。
時刻(位置)ごとに作成する。
Value を引くための重みとして Query と Key の内積(≒ コサイン類似度)を取る、という使い方をするので、Query の特徴量次元は Key の次元 $d_K$ と一致している必要がある。
Key, Value と同様に、Query を生成するための元データ $Y$ の特徴量次元を $N_Y$、系列長を $T_Y$ とすれば、重みとなる $N_Y \times d_K$ 行列 $W_Q$ を用いて、
\[Q = Y W_Q\quad [T_Y \times d_K]\]と計算される。
層の出力の計算
Query 行列 $Q\ [T_Y \times d_K]$ と Key 行列 $K\ [T_X \times d_K]$ の転置をかけた
\[QK^T\quad [T_Y \times T_X]\]は、Query 側の各時系列 $1, \cdots, T_Y$ と Key 側の各時系列 $1,\cdots,T_X$ の全ての組み合わせの類似度(関連性の高さ)を表す行列になる。
この類似度を SoftMax で確率に変換し、これで重み付けして Value 行列 $V\ [T_X \times d_V]$ の和を取ることで、Attention 層の出力 $Z$ が計算できる:
\[Z = SoftMax\left(QK^T\right) V\quad [T_Y \times d_V]\]この処理は、Query との類似度によって Value の重み付け平均を取る操作に等しい。
すなわち、Value が持つ情報のうち Query に関連する部分に注目(= Attention)して抽出している。
実際の計算では、$QK^T$ が大きくなりすぎると勾配消失の懸念が出てくるため、安定化のためのスケール調整 $1/\sqrt{d_k}$ をかけてから SoftMax を計算するのが一般的:
\[Z = SoftMax \left(\cfrac{QK^T}{\sqrt{d_k}}\right) V\quad [T_Y \times d_V]\]Key, Value を作る元データ $X$ と Query を作る元データ $Y$ が同じである場合を Self-Attention と呼び、異なる場合を Cross-Attention と呼ぶ。
Masked Self-Attention
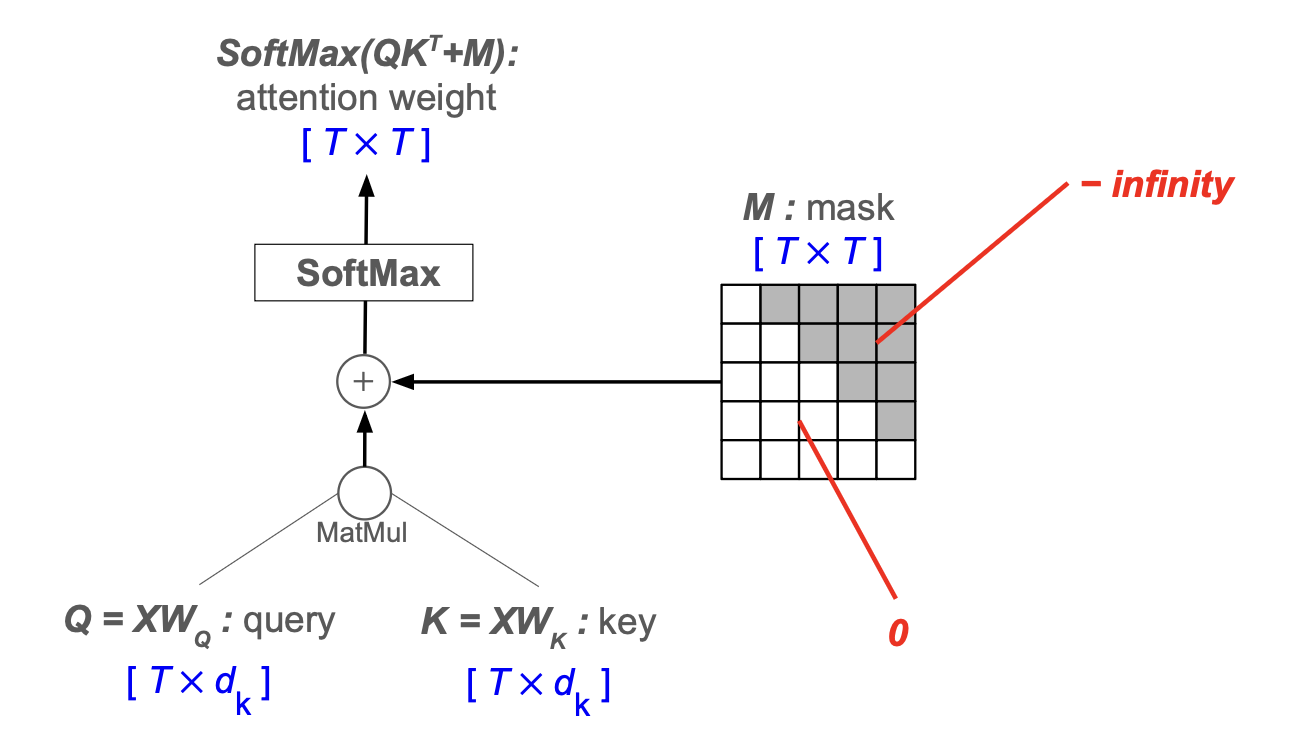
Encoder のデータは、学習時でも推論時でも系列全てが与えられることが多い。
一方で、Decoder の一般的な推論では出力トークンを1単語ずつ順に予測していく処理の流れになるため、「今推論しようとしている時刻よりも先の未来」が見えるのは現実的ではない。
そのため上図のように、絶対値が非常に大きな負の数を右上三角部分に持つマスク行列 $M$ を導入する。
\[M = \begin{pmatrix} 0 & -\infty & \cdots & -\infty \\ 0 & 0 & \ddots & \vdots \\ 0 & 0 & 0 & -\infty \\ 0 & 0 & 0 & 0 \end{pmatrix}\]これを $QK^T$ に加算して $QK^T+M$ の SoftMax を取ることで、未来時刻データとの関連度が(ほぼ)ゼロになるように調整する。
\[Z_\rm{masked} = SoftMax \left(\cfrac{QK^T}{\sqrt{d_k}}+M\right) V\quad [T_Y \times d_V]\]Positional Encoding
Transformer では、各トークンどうしの相互関係は計算するが、トークンの前後関係、時系列的なと遠さといった位置情報が失われる。
そこで、同じ単語であっても位置(時刻)が違えば値が異なるように、以下の Positional Encoding
\[\begin{eqnarray} PE(pos, 2i) &=& \sin\left( \cfrac{pos}{10000^{2i/d_{model}}} \right) \\ PE(pos, 2i+1) &=& \cos\left( \cfrac{pos}{10000^{2i/d_{model}}} \right) \end{eqnarray}\]を元ベクトルに加える処理を行う。
\[x_{pos,i} \leftarrow x_{pos,i} + PE(pos, 2i \ \mathrm{or}\ 2i+1)\]各変数の定義は以下の通り:
- $pos$:系列内のトークンの出現位置(時刻 $t$)
- $2i,\ 2i+1$:特徴量次元のインデックス(何番目の特徴量か)
- $d_{model}$:入力トークンベクトルの特徴量次元
Multi-head Attention
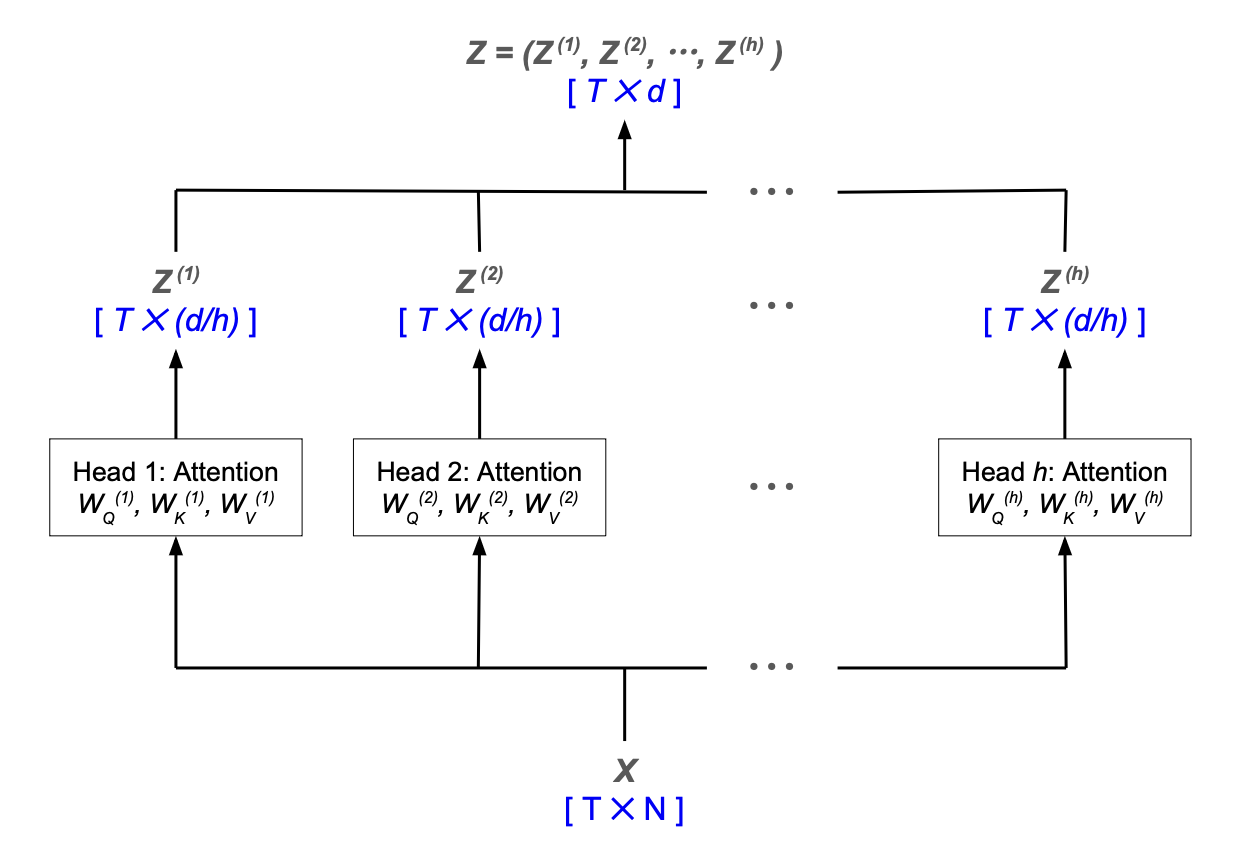
前述の Self-Attention, Cross-Attention において、d ss複数の小さな Attention 機構(= head)を並列で計算し、最後に結果を1つに統合して最終的な Attention 層の出力とする手法。
計算手順
以下に具体的な手順と計算式を示す。
- 特徴量次元 $N$ の入力 $X$ に対して、$h$ 個の $N \times (d_K/h)$ 次元配列 $W_Q^{(i)},W_K^{(i)}\ (i=1,\cdots,h)$ と $N \times (d_V/h)$ 次元配列 $W_V^{(i)}$ をかけることで $N \to d_K/h, d_V/h$ 次元の $Q^{(i)}, K^{(i)}, V^{(i)}$ に射影(線形変換と同時に次元削減)
- $h$ 個の Attention 機構をそれぞれの $Q^{(i)}, K^{(i)}, V^{(i)}$ に適用して、出力群 $Z^{(i)}$ を計算
- $Z^{(1)},\cdots,Z^{(h)}$ を横に連結(concat)して、$T_Y\times d_V$ 次元の最終出力 $Z$ を得る
Multi-head Attention の利点
利点1:多様な関連性の学習
1つの Attention head では、入力系列内の 1種類の依存関係(関連性) しか学習しづらいという特徴がある。
たとえば自然言語の場合:
- Head 1:主語と動詞の関係
- Head 2:形容詞と名詞の関係
- Head 3:文脈的な照応(「彼」が誰を指すか)
- Head 4:時制や文末の情報
といったように、複数の head(= Attention 機構)を用いれば、文の意味を多面的に捉えることができる。
$Q, K, V$ の次元削減の際に head ごとに異なる線形変換 $W^{(i)}$ を行うので、それぞれ異なる射影空間(特徴空間)に変換してから Attention を取る形となり、多様な関連性を学習できる。
利点2:GPU 実装による高速化
計算を並列化しやすくなるので、GPU 実装による高速化の恩恵も受けることができる。
【NOTE】Multi-head と Single-head の計算量
以下の通り、Multi-head と Single-head の計算量のオーダーは同等。
Single-head:
- $Q, K, V$ の計算:(添字省略)$T\times N$ 行列と $N\times d$ 行列の積なので、$O(TNd)$
- 内積 $QK^T$:$T_Y \times d_K$ 行列と $d_K\times T_X$ 行列の積なので、$O(T_X T_Y d_K)$
- 重み付き和 $SoftMax(\cdots) V$:$T_Y \times T_X$ 行列と $T_X\times d_V$ 行列の積なので、$O(T_X T_Y d_V)$
Multi-head:
- $Q^{(i)}, K^{(i)}, V^{(i)}$ の計算:(添字省略)$T\times N$ 行列と $N\times (d/h)$ 行列の積を $h$ 回計算するので、$O(TNd/h)\cdot h = O(TNd)$
- 内積 $Q^{(i)}K^{(i)T}$:$T_Y \times (d_K/h)$ 行列と $(d_K/h)\times T_X$ 行列の積を $h$ 回計算するので、$O(T_X T_Y d_K/h)\cdot h = O(T_X T_Y d_K)$
- 重み付き和 $SoftMax(\cdots) V^{(i)}$:$T_Y \times T_X$ 行列と $T_X\times (d_V/h)$ 行列の積を $h$ 回計算するので、$O(T_X T_Y d_V/h)\cdot h = O(T_X T_Y d_V)$
実装・動作確認
コード
Embedding:
Positional Encoding:
Layer Normalization:
Transformer のエンコーダ・デコーダ:
Transformer seq2seq モデル:
動作確認
単語列をそのまま出力:
# 訓練データ・テストデータ生成
N_train, N_test = 5000, 500
X, Y = Seq2SeqData().addition_formula(N_train + N_test)
X_train, Y_train = X[:N_train], Y[:N_train]
X_test, Y_test = X[N_train:], Y[N_train:]
V = max([X.max(), Y.max()])

# モデル初期化・学習
model = TransformerSeq2Seq(X_train, X_train, X_test, X_test, V, H_embed=32, H_qk=32, H_ff=32, is_input_reversed=False)
model.train(epoch=100, mini_batch=100, eta=0.02, log_interval=1)
model_r = TransformerSeq2Seq(X_train, X_train, X_test, X_test, V, H_embed=32, H_qk=32, H_ff=32, is_input_reversed=True)
model_r.train(epoch=100, mini_batch=100, eta=0.02, log_interval=1)

# 学習曲線を描画
plt.figure(figsize=(13, 8))
plt.subplots_adjust(wspace=0.2, hspace=0.4)
plt.subplot(2, 3, 1)
plt.ylabel('Baseline', fontsize=20)
model.plot_accuracy_seq_level()
plt.subplot(2, 3, 2)
model.plot_accuracy_token_level()
plt.subplot(2, 3, 3)
model.plot_loss()
plt.subplot(2, 3, 4)
plt.ylabel('Input Reversed', fontsize=20)
model_r.plot_accuracy_seq_level()
plt.subplot(2, 3, 5)
model_r.plot_accuracy_token_level()
plt.subplot(2, 3, 6)
model_r.plot_loss()
plt.show()
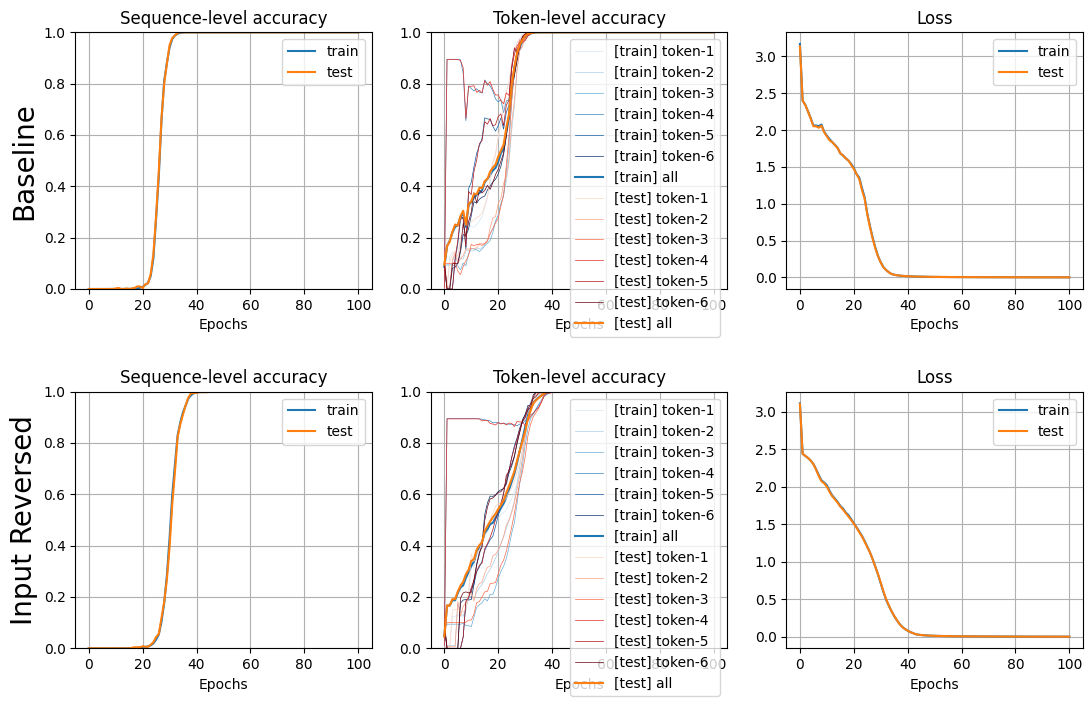
→ 少ない epoch でほぼ100%の正解率に。最初でも最後でもなく、中途半端な4トークン目の accuracy が素早く立ち上がる理由は謎
足し算の計算:
# モデル初期化・学習
model = TransformerSeq2Seq(X_train, Y_train, X_test, Y_test, formula.V, H_embed=32, H_qk=32, H_ff=32, is_input_reversed=False)
model.train(epoch=1000, mini_batch=100, eta=0.2, log_interval=20)
model_r = TransformerSeq2Seq(X_train, Y_train, X_test, Y_test, formula.V, H_embed=32, H_qk=32, H_ff=32, is_input_reversed=True)
model_r.train(epoch=1000, mini_batch=100, eta=0.2, log_interval=20)

# 学習曲線を描画
plt.figure(figsize=(13, 8))
plt.subplots_adjust(wspace=0.2, hspace=0.4)
plt.subplot(2, 3, 1)
plt.ylabel('Baseline', fontsize=20)
model.plot_accuracy_seq_level()
plt.subplot(2, 3, 2)
model.plot_accuracy_token_level()
plt.subplot(2, 3, 3)
model.plot_loss()
plt.subplot(2, 3, 4)
plt.ylabel('Input Reversed', fontsize=20)
model_r.plot_accuracy_seq_level()
plt.subplot(2, 3, 5)
model_r.plot_accuracy_token_level()
plt.subplot(2, 3, 6)
model_r.plot_loss()
plt.show()
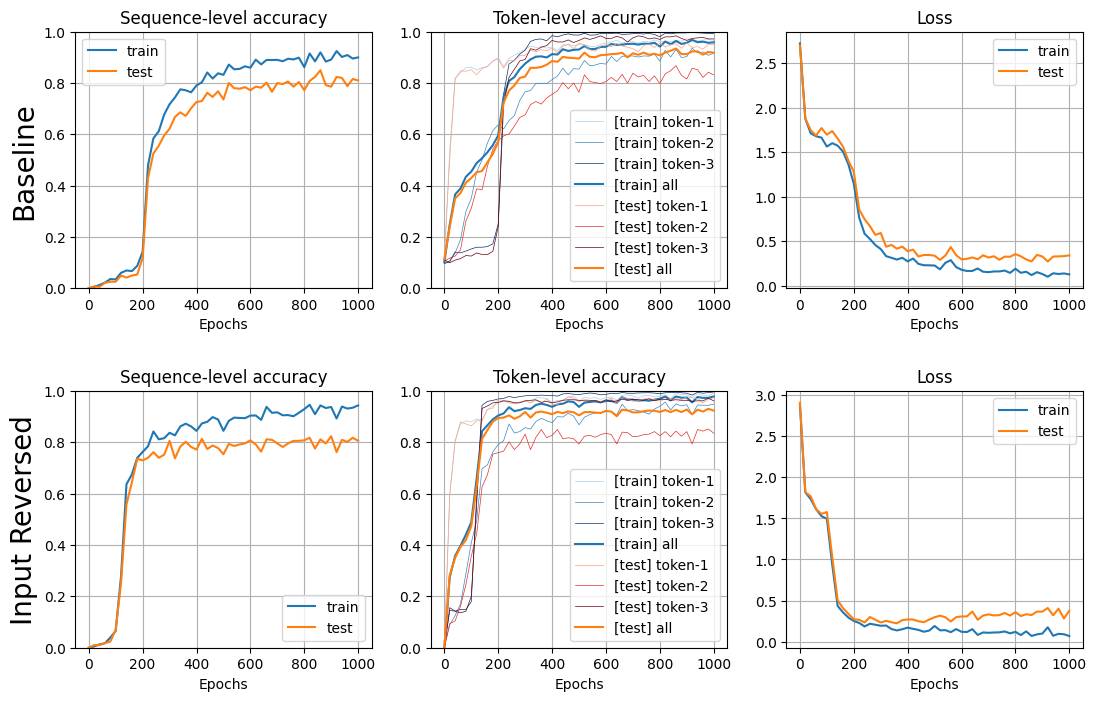
正解率が低いので Multi-head Attention を適用してみる(n_head=4):
model = TransformerSeq2Seq(X_train, Y_train, X_test, Y_test, formula.V, H_embed=32, H_qk=32, H_ff=32, n_head=4, is_input_reversed=False)
model.train(epoch=1000, mini_batch=100, eta=0.2, log_interval=20)
model_r = TransformerSeq2Seq(X_train, Y_train, X_test, Y_test, formula.V, H_embed=32, H_qk=32, H_ff=32, n_head=4, is_input_reversed=True)
model_r.train(epoch=1000, mini_batch=100, eta=0.2, log_interval=20)
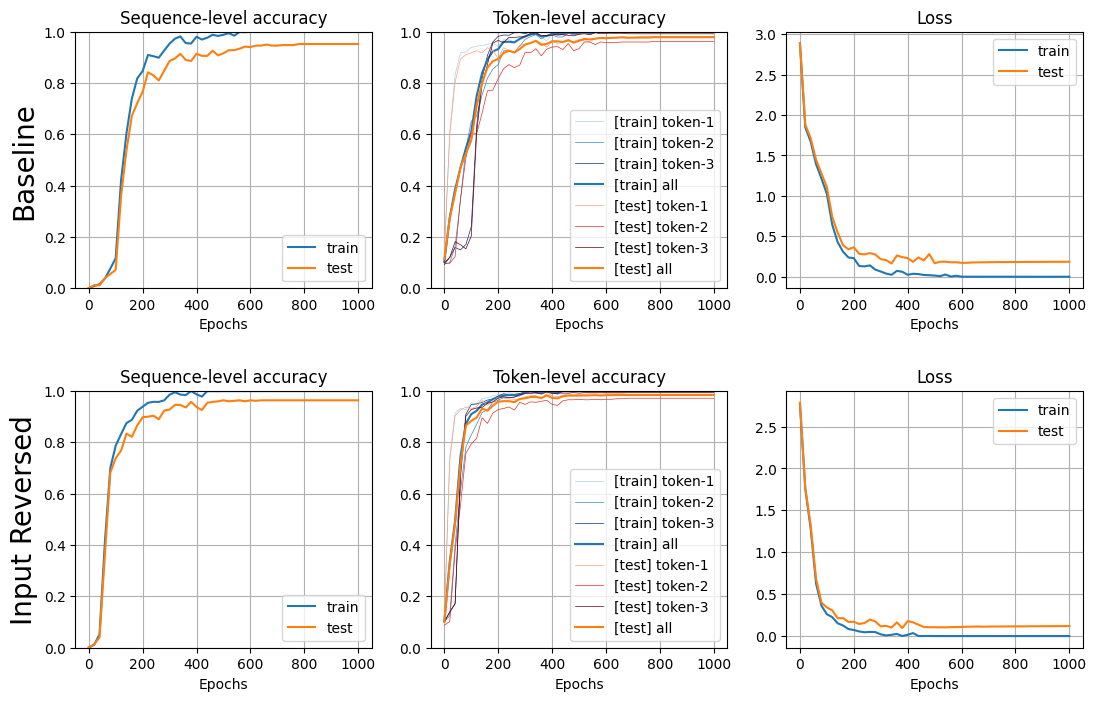
→ 大幅に正解率が上昇し、収束までのエポック数も小さくなった